デルタ法は、推定量を滑らかな関数で変換したあとの標準誤差を、変換前の標準誤差と微分係数から近似する方法です。標本平均の揺れが分かっているとき、その平均の対数のように「変換した指標」の揺れを、取り直した実験なしに見積もれます。
たとえば購入金額の平均は、円で揺れています。その平均に対数を取ると、見たいのは「円が何円動くか」ではなく「平均が何割動くか」に近くなります。デルタ法は、この変換を接線の傾きで置き換えます。傾きが 2 なら揺れはおよそ 2 倍、傾きが半分なら揺れもおよそ半分です。
1. 変換すると、標準誤差はそのままでは移せない
標準誤差は、同じ調査をもう一度やったときに、推定値がどれだけ揺れるか、その大きさです。
購入金額のような正のデータの平均 \(\bar{x}\) は、円の量です。前年との比のように倍率で見たいときは、平均そのものに対数を取ります。\(\log\bar{x}\) です。ここで \(\log\) は自然対数で、底が \(e\) の対数です。円の標準誤差を、対数の横へそのまま書くと、単位が合いません。
混ざりやすいのが、1 件ずつ対数を取ってから平均した \(\overline{\log x}\) です。これは「対数の平均」で、今見たい「平均の対数」とは別の量です。金額の分布が歪んでいると、二つの値はずれます。

式を見る前に、変換しているのが「平均」なのか「1件ずつの金額」なのかだけ先に分けると、あとの標準誤差がどちら向けか迷いません。
標準誤差の作り方と、標本平均が正規に近づく理由は、次の記事に任せます。
2. 接線だと、揺れは傾き倍になる
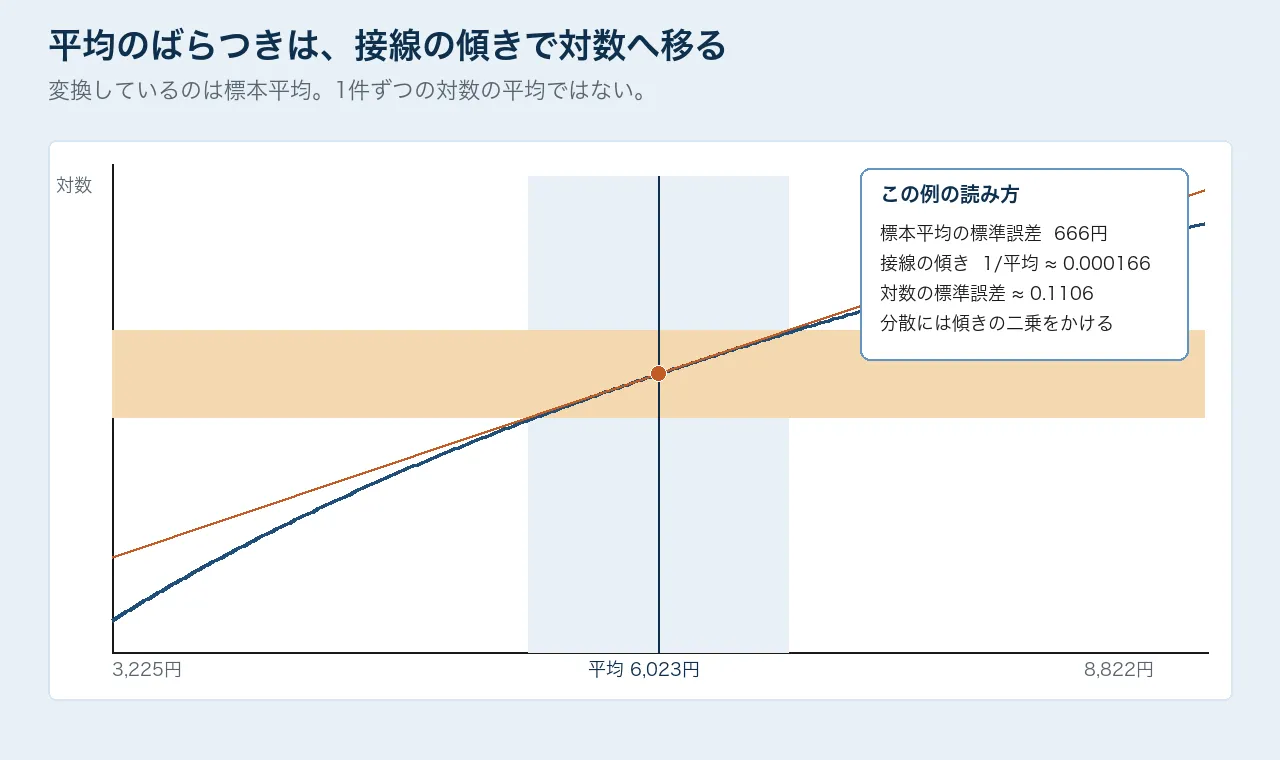
平均が少し動いたとき、対数は曲線そのものではなく、その点の接線に沿って動く、とみなします。接線の傾きが分かれば、変換前の揺れにその傾きを掛けるだけで、変換後の揺れになります。
真の値を \(\theta\)、推定値を \(\hat\theta\)、変換を \(g\) と書きます。\(\theta\) の近くでは
\[ g(\hat\theta) \approx g(\theta) + g'(\theta)\,(\hat\theta-\theta) \]
です。右辺の揺れは、元の揺れ \((\hat\theta-\theta)\) に、定数 \(g'(\theta)\) を掛けたものです。標準誤差は傾きの絶対値倍、分散は傾きの二乗倍です。
\[ \mathrm{SE}\bigl(g(\hat\theta)\bigr) \approx \bigl|g'(\theta)\bigr|\,\mathrm{SE}(\hat\theta), \qquad \mathrm{Var}\bigl(g(\hat\theta)\bigr) \approx \bigl[g'(\theta)\bigr]^{2}\,\mathrm{Var}(\hat\theta) \]
対数 \(g(\theta)=\log\theta\) では、傾きは \(1/\theta\) です。平均が大きいほど、同じ円の揺れでも対数の揺れは小さくなります。
ここまでの式は、揺れの大きさについての近似です。期待値と分散を、接線で置き換えた関係、と言い換えられます。接線で置き換える操作を、テイラー展開の一次近似と言います。
これとは別に、「標本を増やすと、変換したあとの推定値も正規分布に近づく」という主張があります。用語では漸近正規性と言います。標本数を大きくしたとき、推定値をその標準誤差で割ったものが、平均 0・分散 1 の正規分布に近づく、という意味です。
平均の対数にもそれがある、と言うには二つ要ります。変換する前の平均が、すでに正規分布に近づいていること。そして、その点の傾きが 0 でないこと。傾きが 0 だと、一次の式は標準誤差を 0 と返してしまい、実際のばらつきを表しません。
3. 平均の対数では、こう計算する
標本平均のように、標本数 \(n\) を増やすと
\[ \sqrt{n}\,(\hat\theta-\theta) \xrightarrow{d} N(0, v) \]
が成り立つとします。左辺は、推定値と真値の差を \(\sqrt{n}\) 倍して、標本を増やすほど差が縮む分を打ち消した量です。矢印は「分布が近づく」です。\(N(0, v)\) は平均 0、分散 \(v\) の正規分布です。
傾きが 0 でなければ、変換したあとも同じ形で正規分布に近づきます。限界の分散は、傾きの二乗倍です。
\[ \sqrt{n}\,\bigl(g(\hat\theta)-g(\theta)\bigr) \xrightarrow{d} N\bigl(0,\ [g'(\theta)]^{2} v\bigr) \]
幅として標準誤差を言うときは平方根を取るので、傾きの絶対値を掛けます。符号は「増えるか減るか」だけで、幅には残りません。
真の \(\theta\) は未知なので、手元の平均と標本標準偏差 \(s\) を入れます。\(s\) は不偏分散の平方根です。平均の対数なら
\[ \widehat{\mathrm{SE}}(\log\bar{x}) = \frac{s/\sqrt{n}}{\bar{x}} = \frac{s}{\bar{x}\sqrt{n}} \]
です。右辺は、平均が相対的に何割揺れるか、と同じ数です。
推定値の中心が、真の変換値からどれだけずれるかは、また別です。曲線の曲がり(二階微分)の大きさで見ます。
最尤推定量は、条件が揃えば漸近正規性を持ちます。その推定量を滑らかな関数に入れたあとの標準誤差も、同じ一次近似で作れます。最尤推定そのものの手順は次へ渡します。
4. 購入金額 30 件で、平均の対数を通す
この例でやること
知りたいこと:30 件の購入金額から平均を出し、その平均の自然対数 \(\log\bar{x}\) の標準誤差を知りたい。
なぜデルタ法か:調査をもう一度やらなくても、平均の標準誤差に、対数の傾き \(1/\bar{x}\) を掛ければ幅が出る。
見ないもの:1 件ずつ対数を取ってから平均した値の標準誤差ではない。
データの置き方:金額は正で、対数を取ると正規分布に近い母集団から出ている、と置く。母平均は 6,601 円、母標準偏差は 5,249 円。変動係数(標準偏差 ÷ 平均)は 0.795 で、平均に対してばらつきが大きい。
ここから 30 件を取った標本では、平均が 6,023 円、標本標準偏差が 3,649 円、平均の標準誤差が 666 円です。平均の自然対数は 8.703 です。同じ 30 件で、1 件ずつ対数を取った平均は 8.53 でした。見ている量は別です。
傾きは \(1/6023 \approx 0.000166\) です。対数の標準誤差は、円の標準誤差にこの傾きを掛けて
\[ 666 \times 0.000166 = 0.1106 \]
です。分散の近似は、その二乗です。
\[ \widehat{\mathrm{Var}}(\log\bar{x}) = (0.000166)^{2}\times\frac{3649^{2}}{30} = 0.0122 \]
\(666/6023=0.1106\) とも一致します。対数の標準誤差 0.11 は、平均が相対的に約 11% 揺れる、という読みです。666 円を対数の欄にそのまま書くと、約 6,000 倍大きい数になります。
0.1106 は対数の幅です。666 円を、そのまま対数の欄に書いた数ではありません。平均が相対的に約 11% 揺れる、という読みと同じ数です。
5. 同じ母集団で、近似の幅を確かめる
上の 0.1106 は、手元の 30 件に平均と標準偏差を代入した値です。式そのものが近いかは、母平均と母分散を既知にして、標本を何度も取り直すと分かります。
取り直した値を並べた分布を、経験分布と言います。その標準偏差が経験標準偏差です。式が出した標準誤差と、この経験標準偏差が近ければ、幅の近似は当たっています。
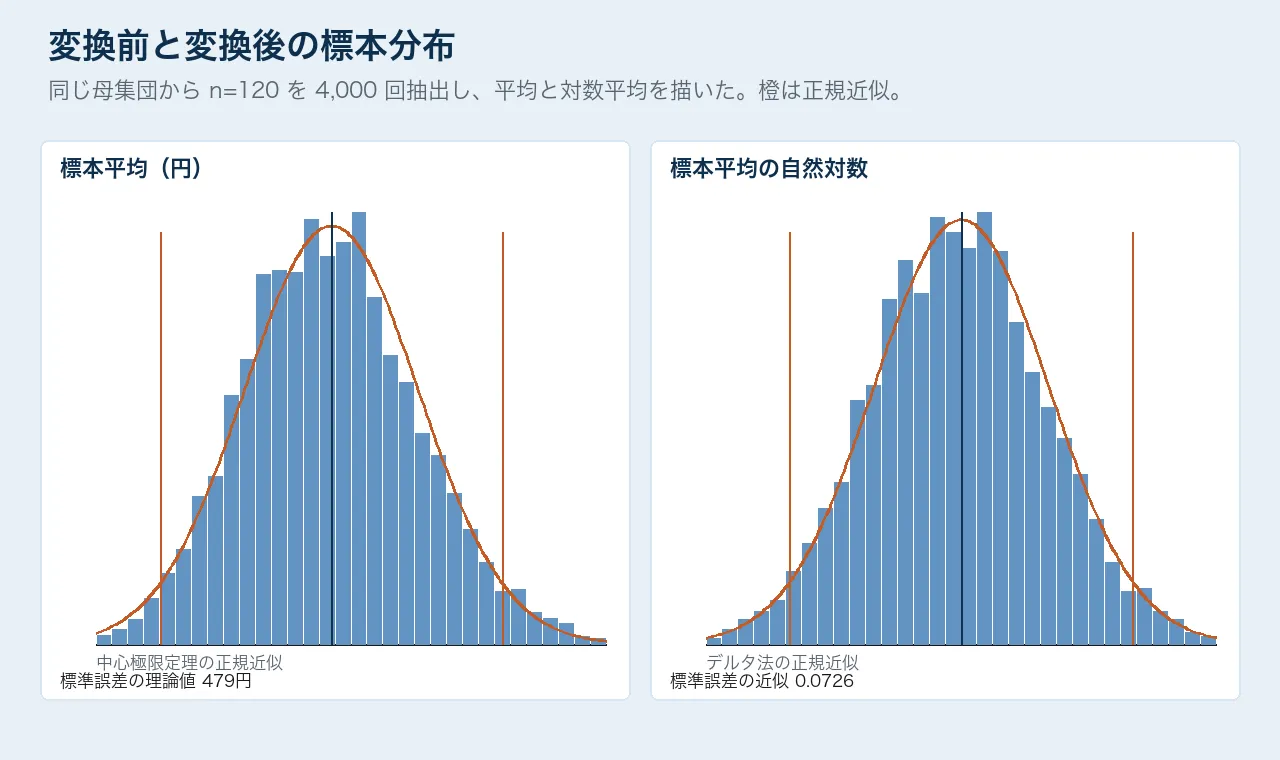
同じ母集団から、大きさ 120 の標本を 4,000 回作りました。毎回、標本平均とその自然対数を記録します。
変換前の平均では、経験標準偏差は 478 円です。中心極限定理が言う標準誤差は 479 円で、揃っています。中心極限定理は、標本を増やすと平均の分布が正規分布に近づく、という主張です。
対数側では、真の平均に置いたデルタ法の標準誤差が 0.0726、経験標準偏差が 0.0723 です。比は 0.995 で、幅はほぼ一致しています。\(\log\mu \pm 1.96\times 0.0726\) が、シミュレーションの対数平均を覆った割合は 0.950 でした。名目の 95% と揃います。
形もほぼ左右対称です。歪度は 0.041 です。中心 \(\log\mu=8.795\) に対し、対数平均の平均は 0.003 だけ低い程度です。
\(n=12\) でも、この対数については幅はまだ近いです。デルタ法の標準誤差 0.2295 に対し、経験標準偏差は 0.2233 です。比は 0.973、名目 95% 区間のカバー率は 0.958 です。歪度は 0.086 で、左右の偏りも小さいままです。
先に見えるずれは、幅ではなく中心です。対数平均の平均は、\(\log\mu\) より 0.0245 低くなります。一次の式は中心を \(g(\theta)\) に置くので、このずれは標準誤差の比だけでは出てきません。
6. ブートストラップとの違い
ブートストラップは、同じ 30 件から復元抽出を繰り返し、毎回 \(\log\bar{x}^{*}\) を計算して、その経験分布の標準偏差を標準誤差にします。接線の傾きは使いません。
この 30 件で 2,000 回抜くと、ブートストラップ標準誤差は 0.1089、抽出ごとの対数平均の平均は 8.698 でした。代入したデルタ法の 0.1106、元の推定値 8.703 と近いです。\(n\) が足りて曲線が局所的にまっすぐなら、両者は同じ幅を別の手続きで見ています。
違うのは前提です。デルタ法は、変換前の標準誤差と微分係数があれば計算が終わります。ブートストラップは、手元の標本を母集団の代理にして、変換後の統計量を直接作り直します。公式が書きにくい関数では、ブートストラップが先の候補になります。回数を増やしても、0 に当たって対数が定義できない問題は残り続けます。
7. 一次近似が信用しにくいとき
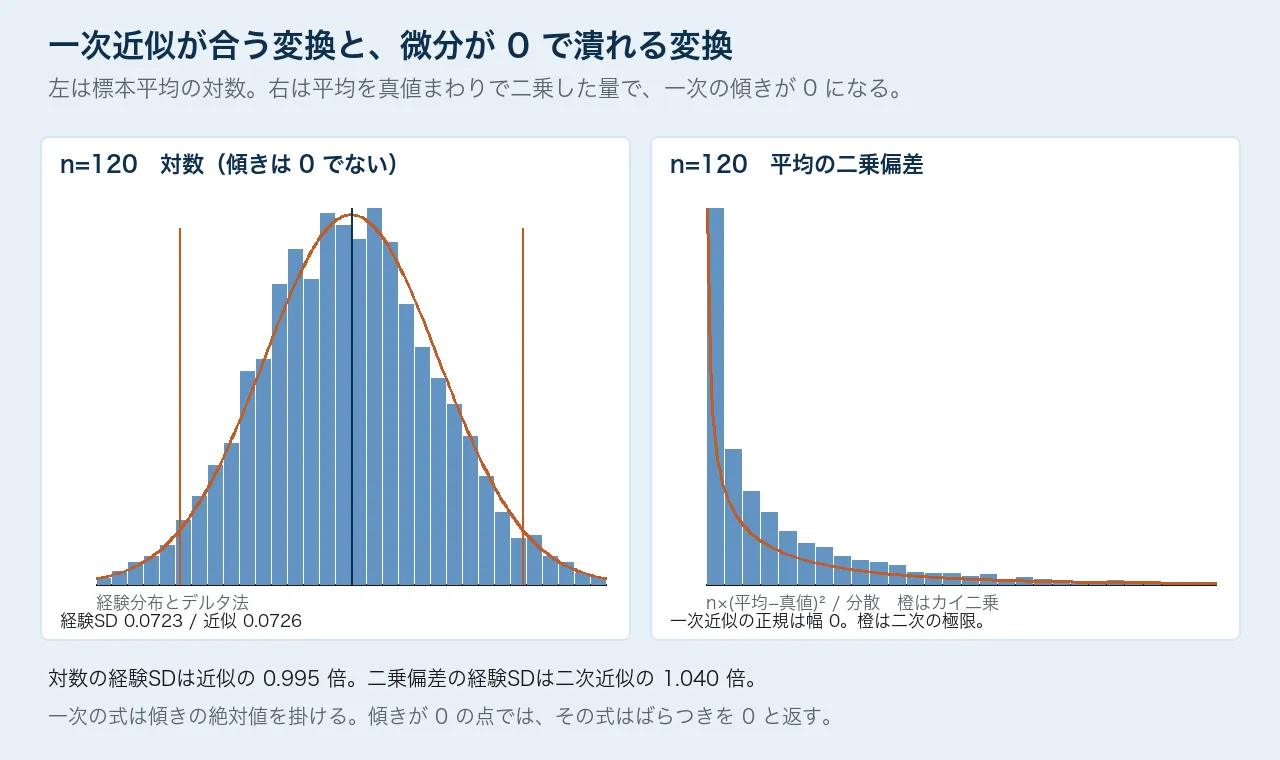
傾きが 0。 \(g(\theta)=(\theta-\mu)^{2}\) は、推定した平均が真の平均とぴったり一致する点で、接線の傾きが 0 です。一次の式は、標準誤差を 0 と返します。
同じ母集団で \(n=120\) を 4,000 回取り、この二乗のばらつきを見ると、0 ではありません。経験標準偏差は、曲がり(二階)まで入れた近似の 1.04 倍です。平均は \(\sigma^{2}/n\) の 1.013 倍です。
傾きが 0 で、曲がりは 0 でないとき、分布の縮み方は \(1/\sqrt{n}\) から \(1/n\) に変わります。近づく先も正規分布ではなく、カイ二乗分布の定数倍です。この例では \(n(\bar{x}-\mu)^{2}/\sigma^{2}\) が、自由度 1 のカイ二乗に近づきます。一次の「平均 \(\pm 1.96\times\) 標準誤差」は、幅が 0 の点に潰れているので使えません。
0 に当たる。 比率 \(p=0.05\) を \(n=40\) で推定し、\(\log\hat{p}\) の標準誤差を一次式で置く実験を 4,000 回行うと、\(\hat{p}=0\) になって対数が定義できない回が残ります。定義できたのは 87.8% です。定義できた回だけ見ると、経験標準偏差はデルタ法の標準誤差 0.6892 の 0.777 倍で、その回に限ったカバー率は 0.999 でした。0 を捨てたあとの幅は、元の実験の幅ではありません。対数を取る前に、推定値が 0 に当たる確率を見ます。
標本が小さい、曲線の曲がりが大きい。 第5節の購入金額では、\(n=12\) でも標準誤差の比は 0.973 でした。小さい標本が、いつも幅を壊すわけではありません。標準誤差ひとつ分の範囲で、接線と曲線が目に見えて離れるときは、一次の式を区間の形に使いません。中心のずれは、幅の式とは別に、曲がり \(g''(\theta)\) と分散の積の半分で点検します。
比率の差や、二つの平均の対数の差のように、変換が二つ以上の推定値にかかるときは、傾きの代わりにそれぞれの偏微分を使います。一本の変換で判断が付けば、計算はここまでの延長です。