回帰モデルの当てはまりを、一つの数字で見たいときに使うのが決定係数 \(R^2\) です。
観測された \(y\) のばらつきのうち、予測値 \(\hat{y}\) がどれだけ説明しているかを表します。1 に近いほど、そのモデルはデータをよく追っています。
決定係数とは何か
決定係数は回帰モデルの説明力を見る指標です。sklearn の r2_score と同じく、1 から残差変動と全変動の比を引いた値です。
定義
$$R^2 = 1-\dfrac{\mathrm{RSS}}{\mathrm{TSS}}=1-\dfrac{\sum_{i}(y_{i}-\hat{y}_{i})^2}{\sum_{i}(y_{i}-\overline{y})^2}$$
残差が小さいほど 1 に近づきます。モデル同士の当てはまりを比べるときに使います。
読み方は次のとおりです。
- 全変動 \(\mathrm{TSS}\) と残差変動 \(\mathrm{RSS}\) を求める
- \(1-\mathrm{RSS}/\mathrm{TSS}\) が決定係数
- 値が 1 に近いほど当てはまりが良い、と判断する。見ていないデータでは負にもなり得る
切片付き最小二乗の当てはめ値では、この値は予測値と観測値の相関係数の 2 乗と一致します。
$$R^2=(corr(y,\hat{y}))^2 \quad \text{(切片付き OLS の当てはめ値に限る)}$$
テストセットの予測や、切片のないモデル、校正がずれた予測では一致しません。相関の 2 乗は負にならず、オフセットも無視します。
回帰そのものは、次の記事が先に読めます。
変動の分解
散布図の各点 \((x_i, y_i)\) から、同じ \(x\) で回帰直線に下ろした点が予測値です。
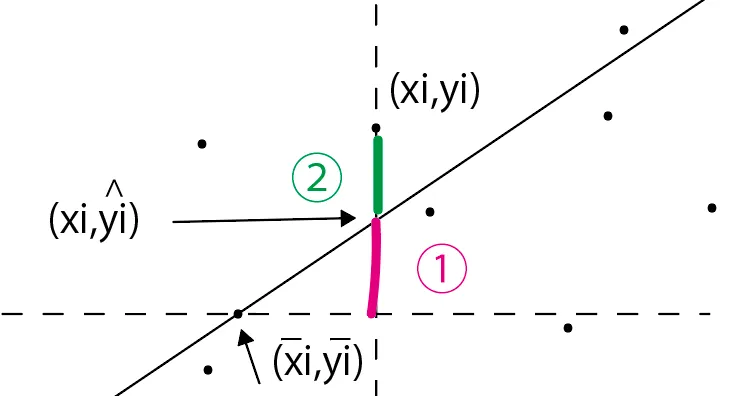
観測値と予測値の差(図の②)が残差変動、予測値と \(y\) の平均の差(図の①)が回帰変動です。二つを足すと全変動になります。全変動は、\(y_i\) の分散を \(n\) 倍したものと一致します。
$$\mathrm{TSS}=\sum_{i=1}^{n}(y_{i}-\overline{y})^2$$
全変動 (TSS) です。
$$\mathrm{ESS}=\sum_{i=1}^{n}(\hat{y}_{i}-\overline{y})^2$$
回帰変動 (ESS) です。
$$\mathrm{RSS}=\sum_{i=1}^{n}(y_{i}-\hat{y}_{i})^2$$
残差変動 (RSS) です。
分解
$$\mathrm{TSS}=\mathrm{RSS}+\mathrm{ESS}$$
切片のある通常の線形回帰では、この等式が成り立ちます。
ここから決定係数は次のように書けます。
$$R^2 = \dfrac{\text{回帰変動}}{\text{全変動}}=1-\dfrac{\text{残差変動}}{\text{全変動}}$$
$$R^2 = \dfrac{\mathrm{ESS}}{\mathrm{TSS}}=1-\dfrac{\mathrm{RSS}}{\mathrm{TSS}}$$
残差変動が大きいほど、予測としては弱いモデルです。分母と分子を \(n-1\) で割ると、切片付き最小二乗では決定係数は「予測値の分散 / 観測値の分散」とも読めます。
残差と誤差項
残差は、観測値から予測値を引いたものです。
$$y_{i}-\hat{y}_{i}$$
誤差項は、モデルが想定する観測のゆらぎです。説明変数と定数項では拾いきれない部分で、正規分布を仮定することが多いです。
$$y_{i}=\beta_{0}+\beta_{1}x_{i}+\varepsilon_{i}$$
違い
残差はデータから計算できる量、誤差項はモデルの仮定です。決定係数が見ているのは残差の大きさです。
Python で計算する
簡単な線形回帰を当てて、決定係数を出してみます。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score

np.random.seed(0)
x = np.random.rand(100, 1) * 100
y = 3 * x + np.random.randn(100, 1) * 10 + 50

model = LinearRegression()
model.fit(x, y)
y_pred = model.predict(x)

plt.scatter(x, y, alpha=0.5, label="Original data")
plt.plot(x, y_pred, color="red", label="Fitted line")
plt.title("Linear Regression")
plt.xlabel("x")
plt.ylabel("y")
plt.legend()
plt.grid(True)
plt.show()
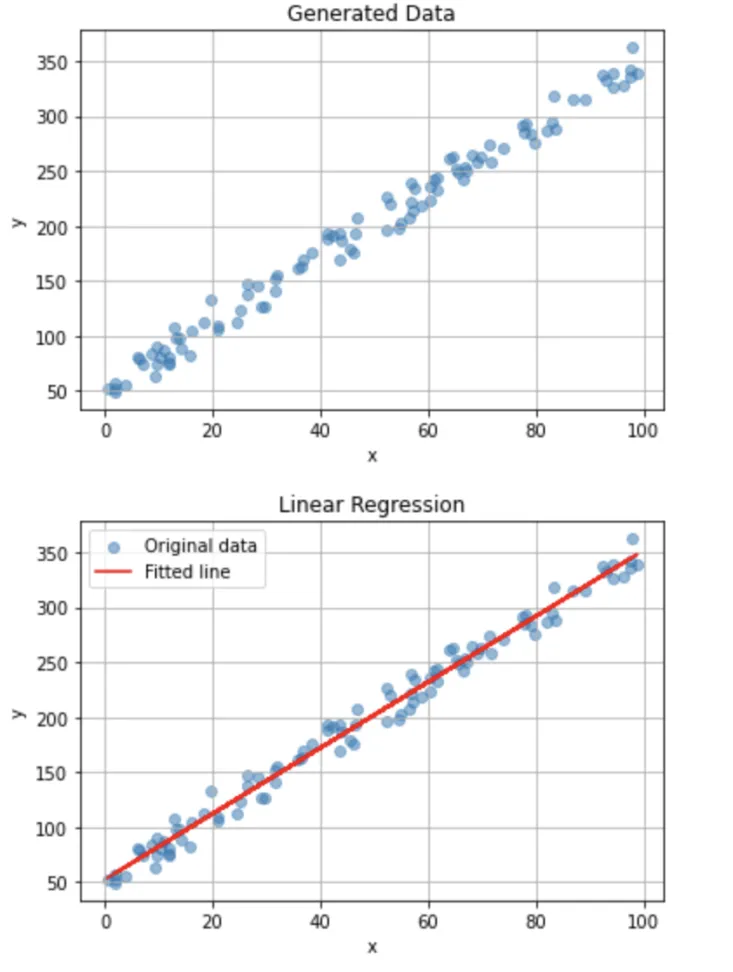
当てはまりの指標として、決定係数を計算します。
r2 = r2_score(y, y_pred)
print(f"The R^2 score of the model is: {r2:.2f}")
The R^2 score of the model is: 0.99
注意
ここでは学習に使った同じデータで \(R^2\) を見ています。0.99 は当てはまりが良いことを示しますが、予測性能の保証ではありません。
自由度調整済み決定係数
決定係数は、説明変数を足すほど上がりやすいという性質があります。変数を増やしただけのモデルが「良い」と見えてしまうので、1980〜90 年代にはこの使い方が疑問視されました。
そこで使うのが自由度調整済み決定係数です。特徴量の次元 \(d\) が増えるほどペナルティがかかります。
$$R^{2}_{\mathrm{adj}} = 1-\dfrac{\dfrac{\sum_{i=1}^{n}(y_{i}-\hat{y}_{i})^2}{n-d-1}}{\dfrac{\sum_{i=1}^{n}(y_{i}-\overline{y})^2}{n-1}}$$
分母は全変動の自由度 \(n-1\)、分子は残差変動の自由度 \(n-d-1\) です。通常の決定係数を使うと、次のようにも書けます。
$$R^{2}_{\mathrm{adj}}=1-(1-R^2)\dfrac{n-1}{n-d-1}$$
統計検定準1級でも、決定係数から調整済み決定係数を求める問題が出ています。

決定係数は 2 乗のイメージがあるので負にならないと思われがちですが、自由度調整済み決定係数は負になり得ます。残差が大きく、自由度で割った結果として下回るからです。
評価指標として入れるのは、被説明変数の予測精度を見たいときです。反対に、説明変数の影響を正しく知りたいときは、欠落変数バイアスを避けるために変数を足すことがあります。その結果として調整済み決定係数が下がっても、それ自体は問題ではありません。
欠落変数については、固定効果推定も参照してください。
決定係数が 1 に近いとき
サンプルが少ないと、学習データでは \(R^2\) がほぼ 1 になっても、新しいデータでは崩れることがあります。これは過学習のサインです。
画像向けのデータ拡張や、アンサンブルは決定係数の定義そのものではありません。まずは残差と変数の数を見た方がよいです。
統計検定2級の式の整理は、2級のチートシートにもまとめています。